Expertises · SRE et observabilité
SRE et observabilité : une production qui tient, et qui se voit
Des alertes qui ne réveillent que quand il le faut, des incidents compris et non répétés, une plateforme qui tient la charge : la fiabilité comme travail quotidien, pas comme promesse.
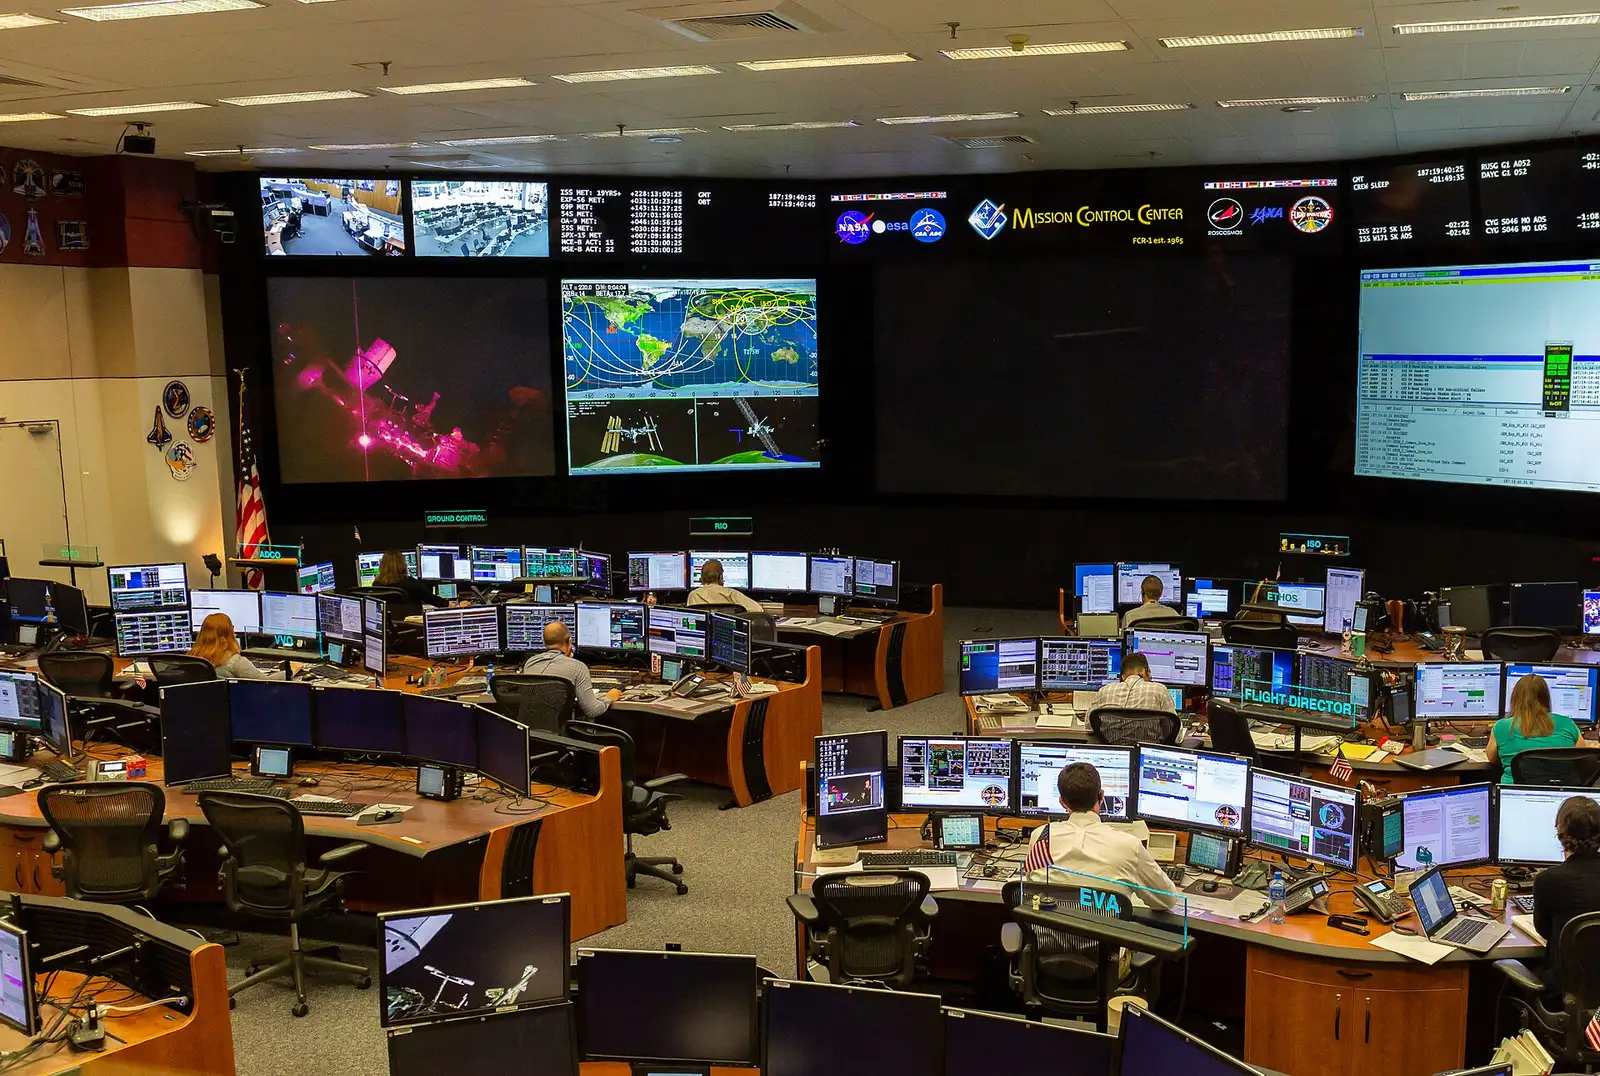
Une alerte qui sonne pour rien est pire qu’aucune alerte
Trop d’alertes et l’équipe n’écoute plus ; pas assez et on apprend la panne par les clients. La fiabilité, c’est d’abord savoir ce qui compte pour vos utilisateurs, le mesurer, et ne réveiller quelqu’un que quand il faut agir.
Ce que nous faisons
- Supervision utile : tableaux de bord par service, métriques, journaux et traces reliés, sur l’outil que vous avez ou que nous mettons en place.
- Des alertes réglées sur l’impact pour vos utilisateurs, chacune avec sa procédure.
- Astreinte 24/7 si votre forfait l’inclut, par un ingénieur qui connaît votre plateforme.
- Runbooks écrits et testés, pour que la réponse à un incident ne dépende pas d’une seule personne.
- Analyses d’incident sans reproche : ce qui s’est passé, pourquoi, et ce qui change pour que ça ne revienne pas.
- Tests de charge avec k6 avant les pics de trafic, pour trouver la limite avant vos clients.
- Agents d’exploitation qui enquêtent et proposent, avec des garde-fous. Voir notre approche et notre méthode avec l’IA.
Si nous faisons bien notre travail, vous n’entendrez pas parler de nous
Votre mois est calme ; le nôtre est plein de mises à jour, de correctifs, d’alertes absorbées et de sauvegardes vérifiées. Tout ce travail reste visible dans Skopea et au comité mensuel.
Pour aller plus loin
La fiabilité au quotidien fait partie de notre infogérance, sur AWS, Azure, Scaleway et Kubernetes.
Questions fréquentes
SRE et observabilité : ce qu’on nous demande
Que fait concrètement un SRE pour nous ?
Il fait en sorte que la production tienne : supervision, alertes, astreinte, analyse des incidents, correction des causes, tests de charge, et réduction du travail répétitif par l’automatisation.
Quel outil de supervision choisir ?
Celui que vous avez déjà, s’il est bien réglé. Nous travaillons avec Grafana et Prometheus, Datadog, New Relic et CloudWatch. Le problème est rarement l’outil, presque toujours le réglage des alertes.
Proposez-vous une astreinte 24/7 ?
Oui, dans le cadre du run au forfait : astreinte des soirs de semaine et des week-ends en option, par un ingénieur qui connaît votre plateforme. Le niveau de couverture est écrit au contrat.
Utilisez-vous l’IA dans l’exploitation ?
Oui, avec des garde-fous : des agents enquêtent et proposent, des seniors décident. Aucune action en production sans validation humaine, et tout est tracé.
Contact
Commençons par un audit
Nous lisons votre plateforme : ce qui est en code et ce qui ne l’est pas, ce qui vous expose, ce qui vous coûte, et ce que nous ferions en premier.
- Premier échange sans engagement
- Un diagnostic écrit, qui reste à vous
- Accès en lecture seule pendant l’audit
Ou écrivez-nous : [email protected]